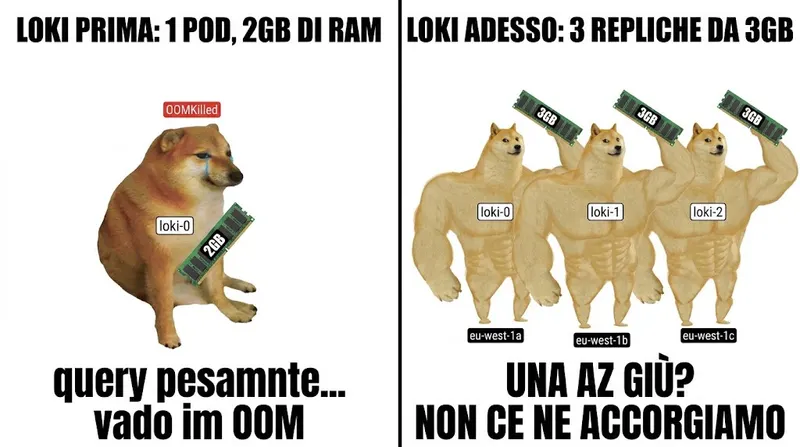
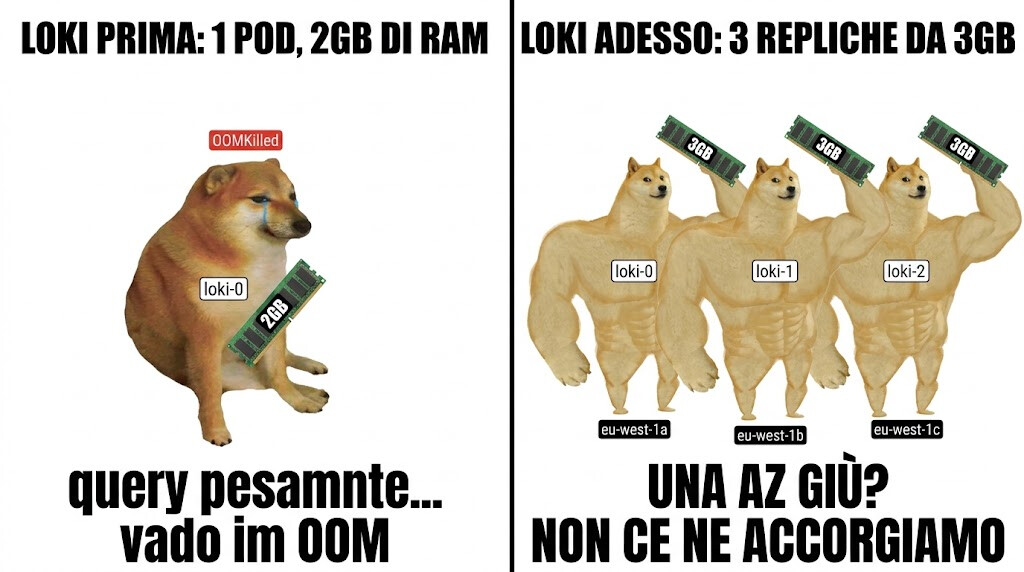
Al lavoro raccogliamo i log di produzione con Loki, in modalità single binary: un solo pod che fa tutto, dalla scrittura alle query. Funziona finché qualcuno non lancia una query pesante, tipo “tutti i namespace, ultimi sette giorni”. Lì il pod saliva fino al limite di 2GB e veniva ucciso per OOM.
La soluzione ovvia sarebbe stata alzare la RAM e chiudere la pratica. Guardando meglio, però, sono saltate fuori un paio di cose.
GOMEMLIMIT sopra il limite
Loki è scritto in Go, e GOMEMLIMIT dice al runtime di Go quanta memoria può usare: quando ci si avvicina, il garbage collector diventa aggressivo e libera memoria prima che sia troppo tardi.
Go non lo capisce da solo
La prima domanda che mi sono fatto: serve davvero? Il runtime non legge il limite del container?
No. Di default Go non ha nessun limite di memoria e non guarda i cgroup. Da Go 1.25 legge dal container il limite di CPU (GOMAXPROCS), ma per la memoria niente. Loki 3.6.7 è compilato con Go 1.24 e non include librerie come automemlimit, che leggono il limite del container e lo passano al runtime.
Senza GOMEMLIMIT decide solo GOGC=100: il GC parte quando l’heap arriva al doppio di quello rimasto vivo dopo il giro precedente. Con 1.6GB di dati vivi il prossimo GC scatterebbe a 3.2GB, ma con un limite di 3GB il kernel uccide il processo prima che il GC ci provi.
Il valore che si era perso per strada
Da noi era impostato a 3750MiB, con il container limitato a 2GB. Il GC credeva di avere quasi il doppio della memoria che aveva davvero, quindi non si sforzava mai: il kernel uccideva il processo molto prima.
Scavando nella storia del repository, nel 2024 quel valore era giusto: il limite era 4GB, e 3750MiB ne erano circa il 92%. Poi il limite è sceso a 1GB, è risalito a 2GB, e GOMEMLIMIT è rimasto dov’era. È il difetto dei numeri scritti a mano: vanno cambiati insieme, e ce ne si dimentica.
Si potrebbe leggere in automatico dal limite del container, con valueFrom.resourceFieldRef: limits.memory, ma così vale il 100% del limite. La guida del GC di Go consiglia invece di lasciare un 5-10% di margine per la memoria che il runtime non vede.
Alla fine l’ho calcolato in Terraform partendo dal limite, e passo entrambi i valori al chart: resta un solo numero da cambiare e il margine c’è sempre.
variable "memory_limit_mib" {
  type    = number
  default = 3072
}

locals {
  gomemlimit_mib = floor(var.memory_limit_mib * 0.9) # 2764
}

resource "helm_release" "loki" {
  # ...
  set = [
    {
      name  = "singleBinary.resources.limits.memory"
      value = "${var.memory_limit_mib}Mi"
    },
    {
      name  = "singleBinary.extraEnv[0].name"
      value = "GOMEMLIMIT"
    },
    {
      name  = "singleBinary.extraEnv[0].value"
      value = "${local.gomemlimit_mib}MiB"
    },
  ]
}
Dai values del chart li ho tolti: il set di Terraform vince comunque, quindi nessuno può più cambiare il limite dimenticandosi di GOMEMLIMIT.
La regola: GOMEMLIMIT intorno al 90% del limite del container. Con 3GB di limite, 2764MiB.
Non fa miracoli
Il limite è soft. Se i dati vivi sono davvero vicini al tetto, il GC gira in continuazione, arriva a mangiarsi circa metà della CPU e alla fine il processo va in OOM lo stesso: si scambia un crash con un rallentamento, e poi il crash arriva comunque.
Aiuta con i picchi di memoria temporanea, che è esattamente quello che fanno le query (tante allocazioni che durano poco), non con dati che non ci stanno. Con 3GB di limite e un uso normale sotto il GB per pod, adesso siamo nel caso in cui aiuta.
Il nodo troppo piccolo
Il pod chiedeva 1GB di memoria (la request) con un limite di 2GB. Lo scheduler, e Karpenter che crea i nodi, guardano solo la request: per loro un nodo con 1GB libero va benissimo.
Infatti l’ho trovato su una t4g.small, che di RAM in tutto ne ha 2GB: su quel nodo il limite di 2GB era irraggiungibile. In più, un pod che usa più memoria di quella che chiede è il primo a essere sfrattato quando il nodo va sotto pressione.
Adesso la request è 2GB e il limite 3GB: i nodi da 2GB sono esclusi in partenza.
Tre repliche, una per zona
Già che c’ero, ho tolto il singolo punto di rottura. Il single binary di Loki può girare con più repliche, a patto che i dati stiano su object storage (da noi S3):
- 3 repliche con
replication_factor: 3: ogni log viene scritto su tutte e tre, quindi se un pod cade le altre due continuano a ricevere scritture e rispondere alle query - una replica per zona di disponibilità, e mai due sullo stesso nodo
singleBinary:
  replicas: 3
  topologySpreadConstraints:
    - maxSkew: 1
      topologyKey: topology.kubernetes.io/zone
      whenUnsatisfiable: DoNotSchedule
      labelSelector:
        matchLabels:
          app.kubernetes.io/name: loki
          app.kubernetes.io/component: single-binary
  affinity:
    podAntiAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        - labelSelector:
            matchLabels:
              app.kubernetes.io/name: loki
              app.kubernetes.io/component: single-binary
          topologyKey: kubernetes.io/hostname
Più un PodDisruptionBudget con al massimo un pod giù alla volta, così Karpenter non me li spegne tutti insieme quando consolida i nodi.
“Ma il disco?”
Era la mia prima domanda. Ogni replica ha il suo volume EBS, creato dallo StatefulSet: sopra ci sono solo il WAL e un po’ di file di lavoro, i log veri stanno su S3. Nessun disco condiviso, nessun problema.
La seconda domanda veniva da un ricordo. Qualche tempo fa, sul vecchio cluster, il pod di Loki finiva in Pending con volume node affinity conflict: il volume stava in una zona e l’autoscaler creava il nodo in un’altra. Da lì era nato un vincolo che teneva Loki fisso in una zona.
Con ogni probabilità il colpevole era Cluster Autoscaler con gruppi di nodi distribuiti su più zone: aggiunge un nodo al gruppo, ma non sceglie in quale zona nasce. Karpenter invece legge la zona del volume e crea il nodo lì. Durante il deploy l’ho visto succedere: la replica che aveva il volume nella prima zona ha aspettato meno di due minuti il suo nodo nuovo, nella zona giusta.
Il vincolo l’ho tolto.
Com’è andato
Il rollout è durato circa quattro minuti, e mentre la replica originale veniva riavviata le altre due tenevano botta: zero errori di scrittura, nessun buco nei log. Nei venti minuti successivi nessun pod è stato riavviato o ricreato.
E una sorpresa positiva: davo per scontato che una query pesante restasse sul pod che la riceve. Invece Loki la spezza e la distribuisce sui querier di tutte e tre le repliche, quindi anche il picco di memoria per pod scende.
Il conto da pagare c’è: ogni log viaggia tra le zone per essere replicato, e AWS il traffico tra zone lo fa pagare. A occhio sono qualche decina di dollari al mese, e in cambio se cade una zona intera non ce ne accorgiamo.