Ultimamente mi sono ritrovato con alcuni pod riavviati per colpa di query molto pesanti sul database. La causa l’abbiamo sistemata a parte e non è di quella che voglio parlare: voglio parlare di chi quei pod li ha riavviati, cioè dei probe.
Li configuro da anni, ma fino a oggi non li avevo mai capiti davvero. Li copiavo da un chart all’altro, cambiavo il path e via.
Chi fa le domande
I probe li esegue il kubelet, l’agente di Kubernetes che gira su ogni nodo. A intervalli regolari interroga ogni container (una chiamata HTTP, una connessione TCP, un comando dentro il container o una chiamata gRPC) e in base alla risposta decide cosa fare. Per HTTP conta come successo qualsiasi codice tra 200 e 399.
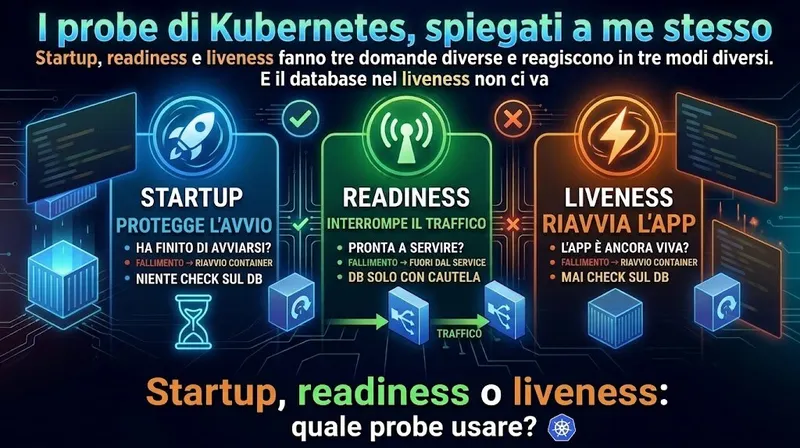
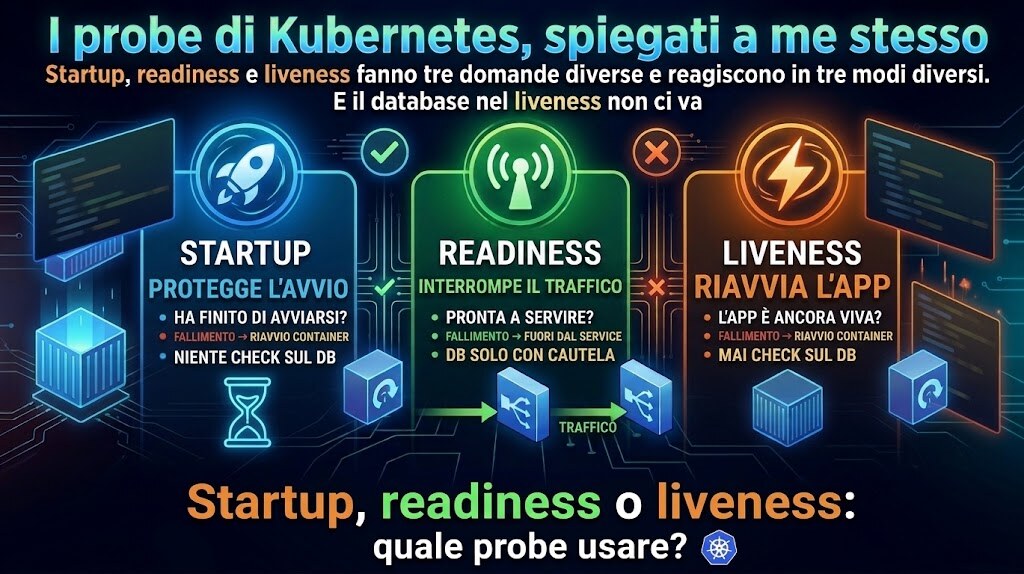
I probe sono tre, e la cosa che mi era sfuggita è che non sono tre varianti dello stesso controllo: ognuno fa una domanda diversa, e quando la risposta è no succede una cosa diversa.
| Probe | Domanda | Se fallisce |
|---|---|---|
| startup | Ho finito di avviarmi? | il container viene riavviato |
| readiness | Posso ricevere traffico adesso? | il pod esce dal Service, nessun riavvio |
| liveness | Sono bloccato al punto che solo un riavvio mi salva? | il container viene riavviato |
Startup: ho finito di avviarmi?
Lo startup probe serve alle applicazioni lente a partire: JVM, cache da scaldare, file da caricare. Finché non ha successo gli altri due probe non girano proprio, quindi il liveness non può uccidere un container che sta ancora caricando. Prima c’era solo initialDelaySeconds, che è una stima a occhio: troppo bassa e il pod viene ucciso a metà avvio, troppo alta e si aspetta per niente a ogni deploy.
Il tempo concesso è failureThreshold × periodSeconds. Superato quello, il kubelet uccide il container e lo fa ripartire. Non è un “aspetto finché non sei pronto”, è un “hai N secondi, poi ricominci da capo”.
Ed è qui che sbagliavo: confondevo startup e readiness. Per me lo startup era il controllo che tiene il pod fuori finché non è pronto davvero, database compreso. Quello però è il lavoro del readiness. Lo startup decide solo quando gli altri due probe possono cominciare, e se scade riavvia.
La differenza si vede quando dentro ci si mette il database. Se il database è giù durante un deploy e il controllo sta nello startup, i pod nuovi falliscono, ripartono, falliscono di nuovo e finiscono in CrashLoopBackOff, con un’attesa tra un tentativo e l’altro che raddoppia fino a cinque minuti. Quando il database torna, i pod possono metterci minuti ad accorgersene.
Con lo stesso controllo nel readiness non riparte niente: il pod resta fuori dal Service finché il database non risponde, poi entra. Quindi lo startup controlla solo l’applicazione, e di solito può usare lo stesso endpoint del liveness con una tolleranza più larga.
Avevo anche in testa che lo startup dovesse verificare che il nodo fosse sano. Non è compito suo: lo stato dei nodi lo seguono il kubelet e il control plane, e un nodo che smette di rispondere viene marcato NotReady e svuotato indipendentemente dai probe.
E il rollout?
Stessa confusione sul rollout: pensavo che fosse lo startup a tenere su i pod vecchi finché i nuovi non sono pronti. Invece il Deployment guarda se i pod nuovi sono Ready, cioè se passano il readiness. Lo startup c’entra solo di riflesso: finché non passa, il readiness non parte e il pod non può essere Ready. Un pod che non diventa Ready non conta come disponibile, e il rollout non va avanti.
Con una precisazione: “i vecchi restano tutti” vale solo con maxUnavailable: 0. Il default è 25%, quindi con 8 repliche, appena parte il rollout, due pod vecchi vengono spenti senza aspettare nessuno. Il 25% si arrotonda per difetto, per cui sotto le 4 repliche il default vale zero e non ce ne si accorge.
strategy:
  type: RollingUpdate
  rollingUpdate:
    maxUnavailable: 0
    maxSurge: 25%
Se i pod nuovi non diventano mai pronti, il Deployment resta a metà. Dopo progressDeadlineSeconds (dieci minuti di default) viene segnato come fallito, ma nessuno torna indietro da solo: il rollback lo deve fare qualcun altro, a mano, con helm upgrade --atomic o con strumenti come Argo Rollouts.
Readiness: posso ricevere traffico adesso?
Il readiness gira per tutta la vita del pod, non solo all’avvio. Quando fallisce, il pod viene segnato come non pronto e tolto dagli endpoint del Service: niente più richieste nuove. Il container però non viene toccato: continua a lavorare, finisce quello che ha in corso, e quando il probe torna a rispondere rientra nel giro.
Nel nostro caso era proprio quello che serviva. Le query pesanti avevano occupato tutte le connessioni del pool verso il database, quindi ogni richiesta nuova si sarebbe messa in coda. Fuori dal Service, il pod smaltisce le richieste che ha già e quelle nuove vanno alle altre repliche. Appena si libera, il readiness torna verde e il pod riceve di nuovo traffico.
Uscire dagli endpoint ferma le connessioni nuove, non quelle già aperte: un client che tiene la connessione in keep-alive verso il ClusterIP può continuare a mandare richieste allo stesso pod. Gli ingress controller che bilanciano direttamente sugli endpoint, come ingress-nginx, invece smettono quasi subito.
Il rovescio della medaglia
Il readiness funziona bene quando il problema riguarda quel pod: il suo pool è pieno, quello delle altre repliche no, e il traffico si sposta.
Ma se è il database a rallentare per tutti, i pool si riempiono su tutte le repliche nello stesso momento. I readiness falliscono insieme, il Service resta senza endpoint e l’ingress risponde 503 a chiunque. Un servizio lento diventa un servizio spento. E già prima di arrivare a zero, ogni pod tolto dal giro scarica il suo traffico sugli altri, che si riempiono prima: effetto domino.
Per questo distinguo due tipi di controllo:
- saturazione locale: “il mio pool ha richieste in attesa?”, “ho ancora worker liberi?”. Riguarda solo questo pod e nel readiness ha senso
- stato di una dipendenza condivisa: “il database risponde?”. La risposta è uguale per tutte le repliche, quindi non aiuta a scegliere a chi mandare il traffico: se fallisce, fallisce ovunque
Il secondo va maneggiato con cura. Togliere tutti i pod dal Service quando il database è giù non salva niente: il servizio sarebbe rotto comunque, solo che al posto di un errore applicativo chiaro gli utenti vedono un 503 generico. A volte va bene così, ma deve essere una scelta, non un effetto collaterale.
Un dettaglio pratico: se il controllo fa una SELECT 1 passando dal pool, con il pool pieno anche il probe si mette in coda e va in timeout, che di default è un secondo. Il risultato è lo stesso, ma per il motivo sbagliato e con una query in più su un database già sotto pressione. Meglio leggere lo stato del pool, se la libreria lo espone.
Liveness: un riavvio mi salverebbe?
Il liveness è quello che fa più danni, perché quando fallisce il kubelet uccide il container e lo fa ripartire. Non nasce un pod nuovo: stesso pod, stesso nodo, stesso IP, e il contatore dei restart che sale.
La domanda giusta non è “sto funzionando bene?” ma “sono bloccato in un modo che solo un riavvio può sistemare?”. Un deadlock, un event loop piantato, un processo vivo che non risponde più a niente: i casi in cui spegnere e riaccendere serve davvero.
Il database qui non c’entra. Se il pool è esaurito perché il servizio sta lavorando, riavviarlo è il contrario di quello che serve:
- le richieste in corso vengono buttate via, e i client probabilmente le ripetono
- il pod deve rifare tutto l’avvio, con cache fredde e connessioni da riaprire, proprio nel momento di carico massimo
- il database non è diventato più veloce, quindi il pool si riempie di nuovo e si ricomincia
E se il controllo sul database è uguale per tutti, le repliche si riavviano tutte, magari insieme, e ognuna riapre il suo pool da capo su un database già in difficoltà.
Anche senza database
Togliere il database dal liveness non basta. Se l’endpoint del liveness viene servito dagli stessi worker che gestiscono le richieste, e tutti i worker sono fermi ad aspettare una connessione, anche lui resta in coda. Il probe va in timeout, tre volte di fila, e il container viene riavviato lo stesso. Con i default bastano una trentina di secondi di saturazione.
I rimedi, meglio se insieme:
- servire i probe fuori dal giro delle richieste: una porta separata, un thread dedicato, comunque un endpoint che non aspetti un worker libero
- dare al liveness una tolleranza larga, con un timeout di qualche secondo e un
failureThresholdche copra un picco di carico. Deve scattare quando il processo è morto davvero, non al primo rallentamento
Come li configuro adesso
Due endpoint:
/healthz/liverisponde 200 se il processo è vivo. Non tocca database, cache o altri servizi/healthz/readyrisponde 503 se il pool verso il database ha richieste in attesa
startupProbe:
  httpGet:
    path: /healthz/live
    port: 8080
  periodSeconds: 5
  failureThreshold: 24   # 2 minuti per partire, poi riavvio
readinessProbe:
  httpGet:
    path: /healthz/ready
    port: 8080
  periodSeconds: 5
  timeoutSeconds: 2
  failureThreshold: 2    # fuori dal Service dopo circa 10 secondi
livenessProbe:
  httpGet:
    path: /healthz/live
    port: 8080
  periodSeconds: 10
  timeoutSeconds: 5
  failureThreshold: 6    # riavvio solo dopo un minuto senza risposta
Per riferimento, i default sono periodSeconds: 10, timeoutSeconds: 1, failureThreshold: 3 e successThreshold: 1. Il più insidioso è il timeout di un secondo: sotto carico basta poco per superarlo.
Non è obbligatorio averli tutti e tre. Senza readiness il pod è pronto appena il container parte; senza liveness il container viene riavviato solo se il processo esce. Un liveness fatto male è peggio di nessun liveness.
In breve
- startup: “ho finito di avviarmi?”. Solo l’applicazione, mai le dipendenze, perché se fallisce riavvia
- readiness: “posso ricevere traffico adesso?”. La saturazione di questo pod sì; le dipendenze condivise solo sapendo che, se cadono, escono dal Service tutti i pod insieme
- liveness: “solo un riavvio mi salva?”. Mai dipendenze esterne, tolleranza larga, e un endpoint che non faccia la coda con le richieste