La sera di Halloween, invece di un film horror, mi sono guardato memtest86+ che riempiva di errori lo schermo del televisore. Paura vera.
Il server di casa è un mini-PC con un Intel N95 e una distro minimale che regge
un po’ di servizi personali e rende la mia tv un po’ più smart. A luglio si era
piantato in un livelock di kswapd: avevo dato la colpa a un bug del kernel,
aggiornato, e mi ero segnato una regola. Se ricapita, memtest.
È ricapitato.
16164 errori in sette minuti
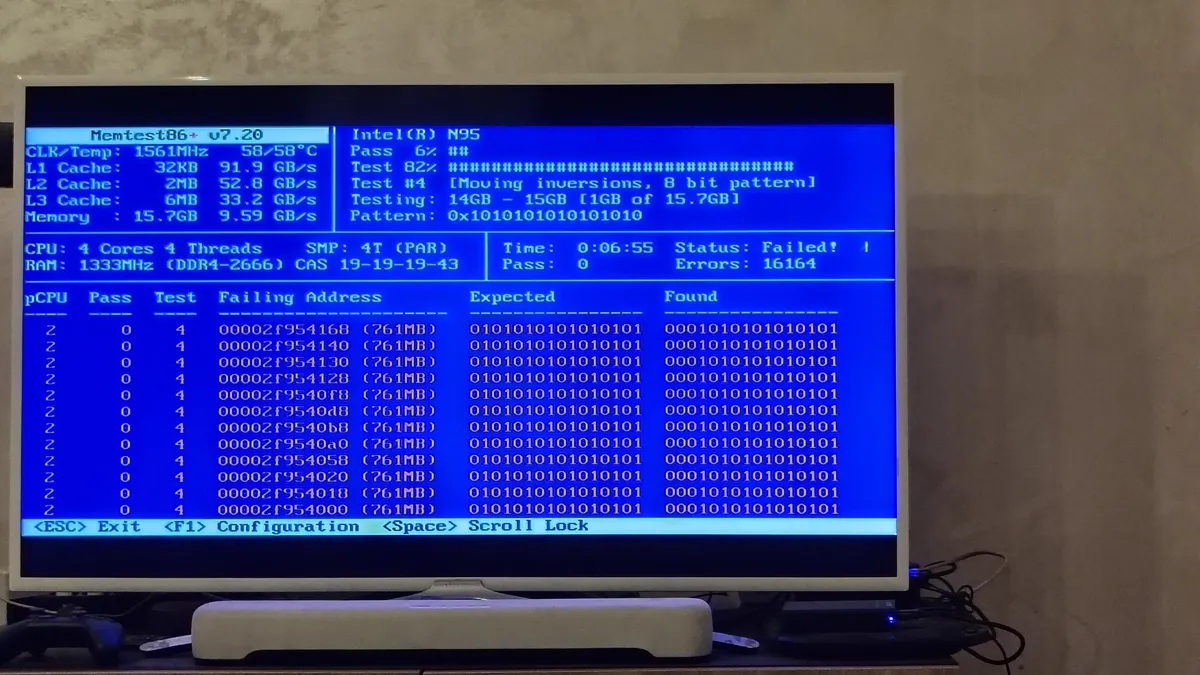
Memtest86+ non è arrivato nemmeno alla fine del primo giro: dopo 6 minuti e 55 secondi aveva già contato 16164 errori.
La cosa interessante è dove. Tutti gli indirizzi stanno intorno ai 761MB
(0x2f954000 e dintorni), e l’errore è sempre lo stesso:
atteso:  0x0101010101010101
trovato: 0x0001010101010101
Un solo bit, il 56, che dovrebbe valere 1 e resta a 0. Su un modulo come questo ogni chip gestisce 8 dei 64 bit del bus, quindi con buona probabilità è un singolo chip con un piccolo gruppo di celle rotte. Non un modulo marcio da cima a fondo: un fazzoletto di qualche KB che non tiene i bit.
Il colpevole
$ sudo dmidecode -t memory
	Size: 16 GiB
	Form Factor: SODIMM
	Type: DDR4
	Speed: 2667 MT/s
	Part Number: KINSOTIN16GB2666MHZ
	Rank: 1
Un unico modulo DDR4 SODIMM da 16GB, marca Kinsotin. L’N95 ha un solo canale di memoria, quindi niente secondo modulo dietro cui ripararsi: o si cambia questo, o si convive con il bit 56.
Già che c’eravamo
Abbiamo smontato il mini-PC e gli abbiamo dato una ripulita. Sorpresa: la parte inferiore nasconde lo spazio per un hard disk. Per tutto questo tempo il server aveva un posto libero sotto la pancia, e non lo sapevo. Ci ho già montato un disco di recupero!
Comprare RAM nel 2026
Qui arriva la seconda parte dell’horror. La DDR4 sta uscendo di produzione e i prezzi della DRAM sono ancora alti: un 16GB SODIMM nuovo di marca, in Italia, sta tra i 90 e i 130€.
Mi sono chiesto se 8GB potessero bastare, e ho misurato. A riposo il server usa
circa 5.3GB; il servizio più pesante, nei picchi, sale a 1.75GB; e i 10GB di
page cache tengono veloci i dati che stanno su dischi USB. Con 8GB starei sempre
in swap, e un server che è già finito in un livelock di kswapd non è il caso
di metterlo alla prova.
Alla fine ho preso un SK Hynix da 16GB DDR4-2666 usato su eBay, a 69,90€, da un venditore professionale. Due criteri: niente marche sconosciute (vedi sopra), e il diritto di recesso di 14 giorni, perché il primo memtest lo faccio io appena arriva. 2666 invece di 3200 non cambia niente: è la stessa velocità del modulo attuale, e per questo carico la banda non è il collo di bottiglia.
Nel frattempo: dire al kernel dove non guardare
Il ricambio ci mette qualche giorno, e nel frattempo database e backup continuano a scrivere passando per quella RAM. Linux permette di escludere le zone guaste, in due modi.
Primo tentativo: memtest=17
Con il parametro memtest=N il kernel, all’avvio, scrive e rilegge N schemi di
bit su tutta la memoria libera e mette da parte gli indirizzi che sbagliano. Il
kernel della mia distro lo supporta (CONFIG_MEMTEST=y), il costo è un avvio più lento
di circa un minuto.
Ha trovato la stessa zona di memtest86+. Peccato che nel log ci fosse anche questo:
aaaaaaaaaaaaaaaa bad mem addr 0x000000002f9573f8 - 0x000000002f957400 reserved
memblock: Failed to double reserved array from 128 to 256 entries !
Ogni indirizzo guasto, 8 byte alla volta, occupa un posto nella tabella delle
zone riservate, che in quella fase dell’avvio ha 128 posti. Dopo un centinaio di
indirizzi era piena: il kernel ha provato a raddoppiarla, non ci è riuscito, e
da lì in poi ha continuato a scrivere reserved per indirizzi che di riservato
non avevano niente. Più di cento celle guaste erano ancora in uso.
Morale: un log che dice “reserved” una riga prima di dire che non ci è riuscito.
Il log, tra l’altro, era così lungo che l’inizio del test era già uscito dal
buffer di dmesg. Per la volta dopo ho aggiunto log_buf_len=8M.
Secondo tentativo: memmap
Visto che il guasto sta tutto in pochi KB, conviene riservare l’intera zona in
un colpo solo, con un po’ di margine. Il parametro memmap=4M$0x2f800000 dice al
kernel di considerare quei 4MB come memoria di un dispositivo, da non toccare.
I memtest successivi non ci guardano più dentro, e la tabella non si riempie.
Sulla riga options della voce di systemd-boot:
memmap=4M$0x2f800000 memtest=17 log_buf_len=8M
Con systemd-boot il $ va scritto così com’è; con GRUB va protetto con un
backslash.
Dopo il riavvio:
user: [mem 0x000000002f800000-0x000000002fbfffff]  device reserved
early_memtest: # of tests: 17
E soprattutto nessun bad mem addr: 17 schemi di bit sul resto dei 16GB e non
salta fuori nient’altro. Il guasto è davvero solo lì. Costo dell’operazione:
4MB di RAM e un minuto di avvio in più.
Cosa mi porto a casa
- Il
kswapddi luglio era un bug del kernel o il primo sintomo del bit 56? Non lo saprò mai. La prossima volta che un server crasha in modo strano, memtest prima di dare la colpa al kernel. - Un messaggio “reserved” nel log non garantisce niente: la verità sta in
/proc/iomem. - Un modulo con un guasto localizzato si può tenere in servizio per qualche
giorno con
memmap, a patto di toglierlo quando si cambia la RAM: gli indirizzi valgono solo per il modulo vecchio.
Il modulo nuovo è in viaggio. Quando arriva: memtest86+ completo, via memmap
e memtest dalla riga di boot, e Halloween torna a essere solo una questione
di zucche.